시작
약국통에 알약 사진을 찍으면 약을 찾아 주는 기능을 넣고 싶었다. 7월 중순 앱 안에서 먼저 시도했다. 알약 이미지 임베딩과 각인, 색·모양을 섞어 후보를 좁히고, 식약처 공식 각인에 OCR 오류 변형을 만들어 각인 사전 매칭을 회귀 평가했다. 매칭 정확도는 69% 에서 78% 로 올랐지만, 앞단의 각인 읽기가 발목을 잡았다.
Apple Vision 은 직접 찍은 실사진 14장 중 5장만 정확히 읽었다. 흰 알약·둥근 알약의 얕은 양각·음각 각인이 특히 읽히지 않았다. 사전학습 OCR 두 종(EasyOCR, PaddleOCR)은 Apple Vision 이 틀린 난례 8장을 하나도 맞히지 못했다. 7월 21일 각인 인식기 연구를 별도 저장소로 떼어 냈다. 상용화보다는 데이터 정리부터 학습·검증·앱 통합까지 한 번 끝까지 돌려 보는 연습에 가까웠다.
규칙은 처음에 하나 정했다. 실사진에서 기존 기준선을 이기기 전에는 앱 모델로 승격하지 않는다. 구현과 실험 실행은 AI 에이전트에 맡기고, 나는 데이터 계약과 검증셋 분리, 승격 게이트를 설계하고, 실패한 이미지를 눈으로 보고 다음 방향을 정했다.
무엇을 만들었나
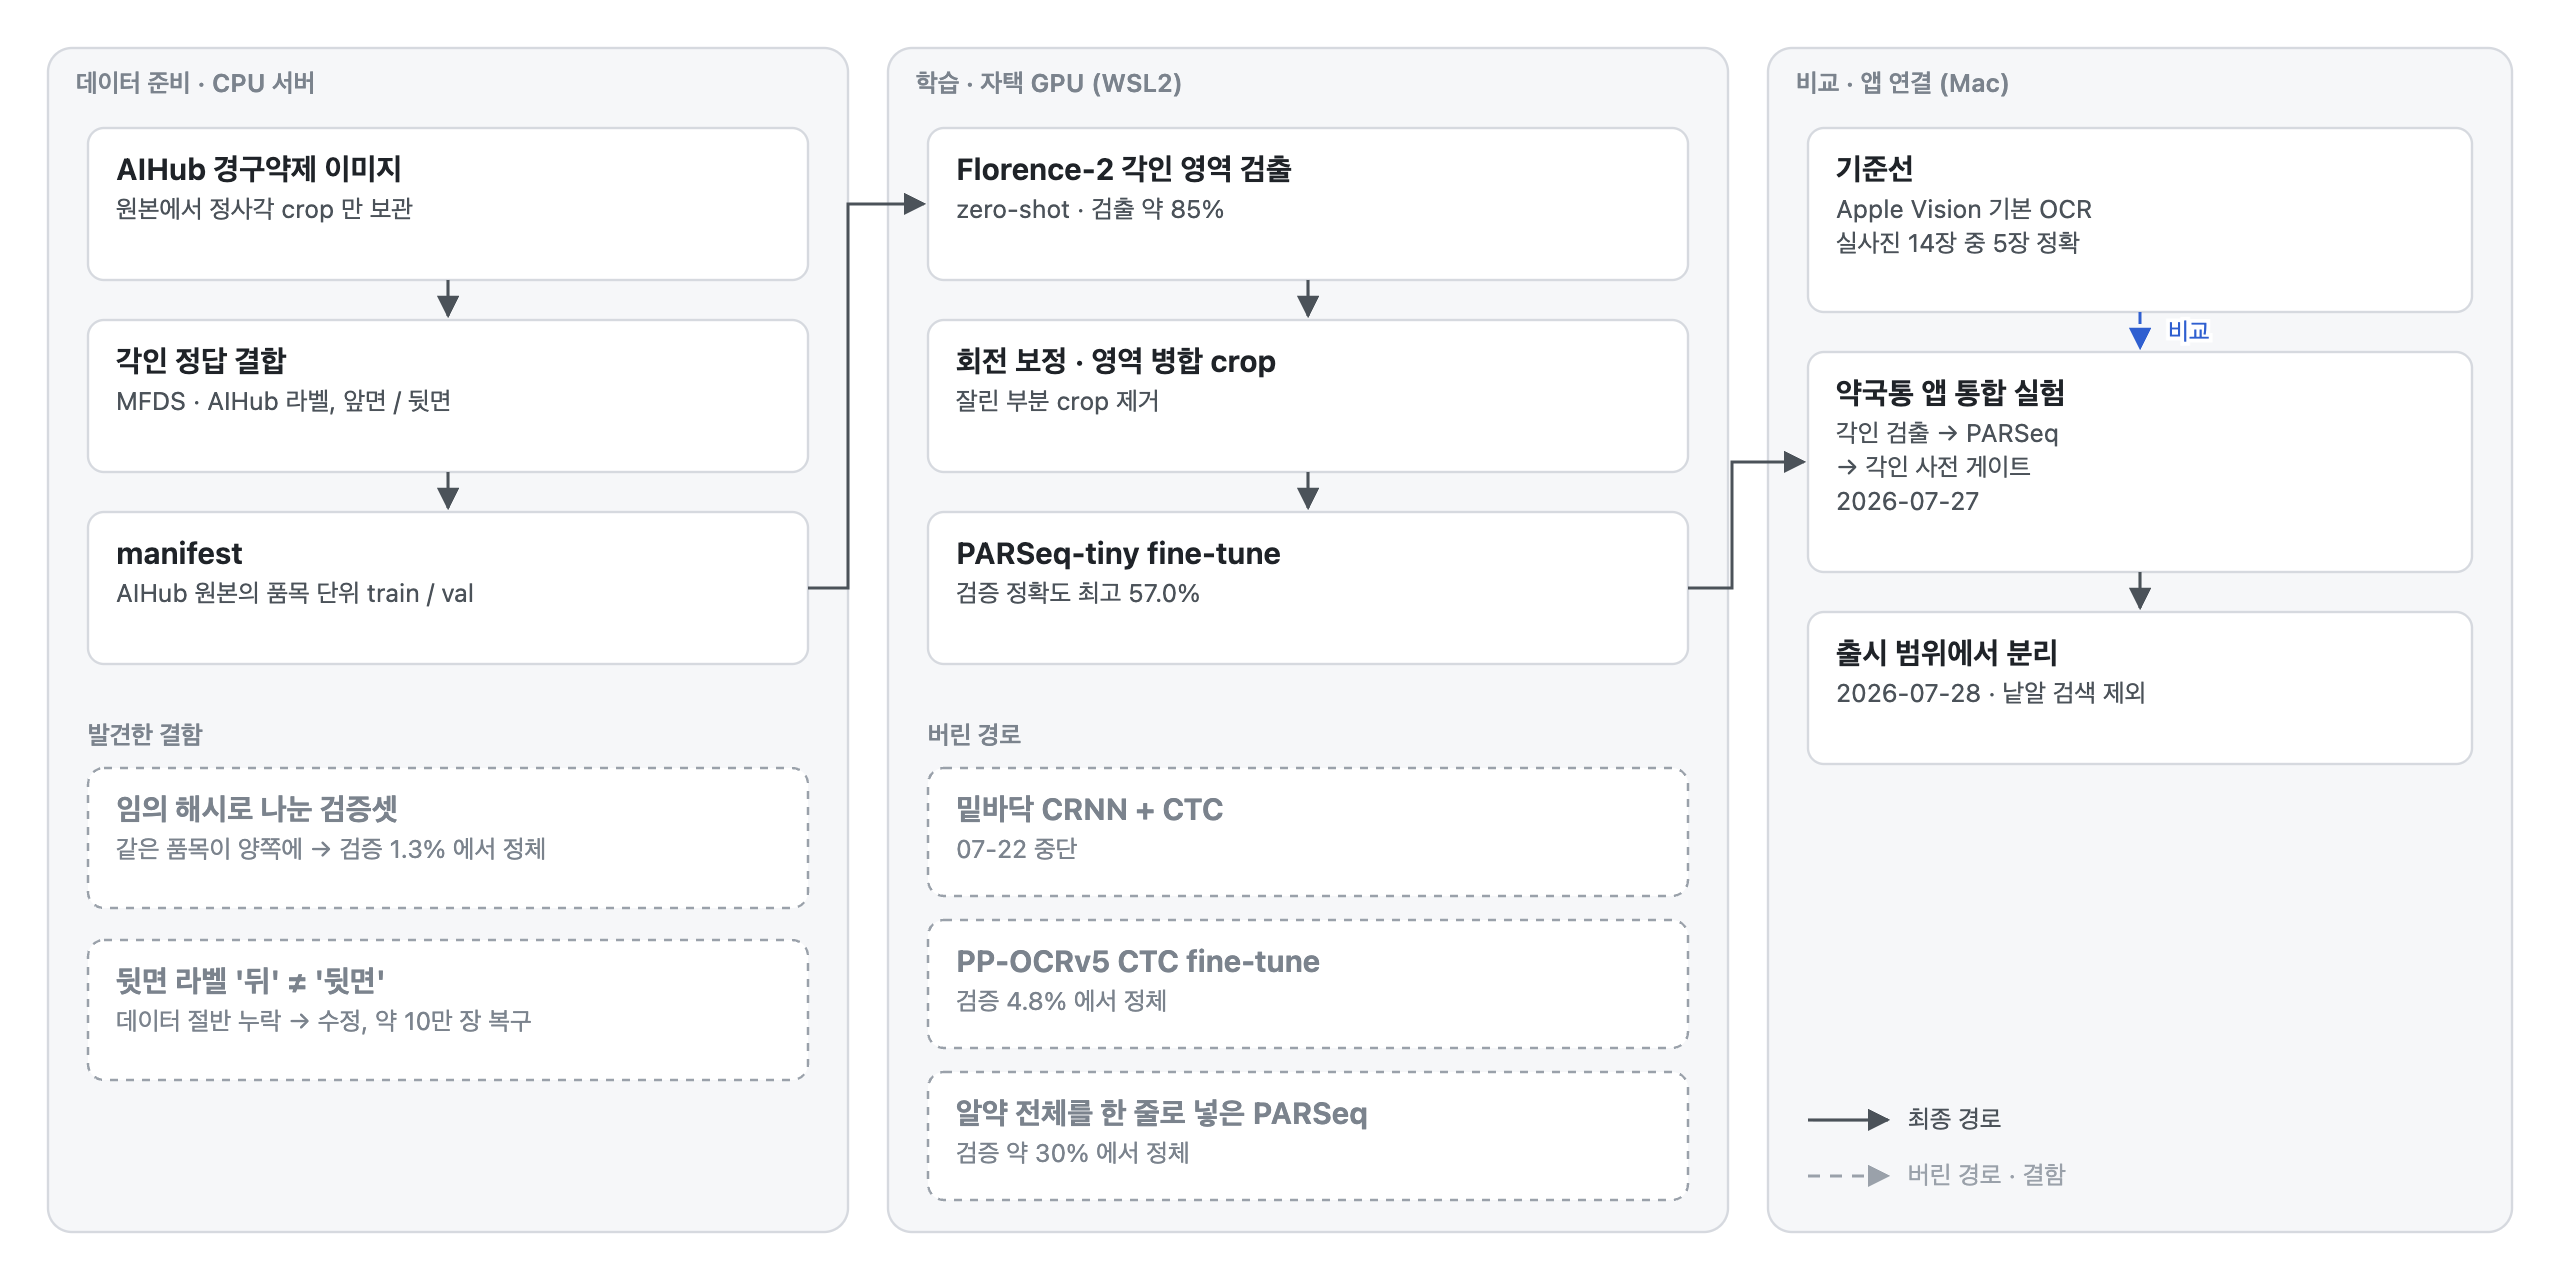
정답 데이터부터 만들었다. AI Hub 경구약제 이미지에서 알약 영역을 정사각으로 잘라 두고, 식약처 낱알식별 데이터의 앞면·뒷면 각인을 정답으로 붙였다. 검증셋은 품목이 학습셋과 하나도 겹치지 않게 AI Hub 원본의 분할을 그대로 썼다. 학습에 약 57만 장, 검증에 약 9만 장을 썼다.
그 위에 최종적으로 남은 파이프라인은 네 단계다. Florence-2 로 알약 사진에서 각인 영역을 찾고, 기울어진 영역을 수평으로 펴고 뒤집힌 글자를 바로 세운 뒤, PARSeq-tiny 로 읽는다. 읽은 문자열은 식약처 각인 사전과 맞춰 확정하거나 후보로 줄 세운다. 수집·학습·모니터링 스크립트와 함께, 실험을 할 때마다 판단 근거를 리포트로 남겼다.
스택 — 밑바닥 대신 이미 글자를 아는 모델
처음 기준선은 CRNN 을 밑바닥부터 학습하는 코드였다. 7월 22일 이걸 중단했다. 알약 각인은 데이터에 비해 글자 모양이 다양하지 않은데, 글자 형상 자체를 처음부터 배우게 할 이유가 없었다. 이미 글자를 학습한 사전학습 인식기를 fine-tune 하는 쪽으로 방향을 잡았고, 인식기는 결국 PARSeq-tiny 로 정했다.
검출은 Florence-2-base(0.23B, MIT) 를 fine-tune 없이 쓴다. 뒤집힌 글자 판정은 PaddleOCR 의 방향 분류기, 얕은 각인이 검출되지 않을 때는 CLAHE 와 unsharp 로 대비를 키워 한 번 더 찾는다. 앱에는 ONNX 로 넣었다.
학습 장비는 도중에 바꿨다. Mac 의 CPU 로는 한 번 돌리는 데 약 8시간이 걸려 가설을 하루 한두 번밖에 확인할 수 없었고, 쓰려던 학습 도구는 Mac 의 GPU 가속을 지원하지 않았다. 집 PC 의 RTX 4060 Ti 에 WSL2 로 학습 환경을 만들자 CPU 대비 약 100배 빨라졌다.
아키텍처 — 데이터 준비, 학습, 앱 연결
데이터 준비는 CPU 서버에서, 학습은 집 PC 의 GPU 에서, 기준선 비교와 앱 연결은 Mac 에서 했다. 그림의 회색 점선은 도중에 발견한 결함과 버린 경로다. 최종 경로보다 버린 경로가 더 많다.
파이프라인이 만들어진 순서
각 단계는 앞 단계 결과를 눈으로 보고 문제를 찾은 뒤에 추가했다. 이미지는 AI Hub 경구약제 공개 데이터와 직접 찍은 사진이다.
| # | 겪은 문제 | 처리 | 전 | 후 |
|---|---|---|---|---|
| 1 | 정사각 알약을 인식기 입력 32×128 로 그대로 넣자 세로가 6.7배 눌려 글자가 뭉개졌다. 본 학습에서도 검증 정확도가 약 30% 에서 멈췄다. | 비율을 지키는 패딩도 시험했지만, 근본 원인은 각인이 아닌 것까지 넣고 있다는 데 있다고 봤다. 각인 검출을 분리하기로 했다. | 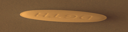 |  |
| 2 | 검출기 후보를 실측했다. 휴리스틱은 저대비에서 위치를 못 잡고, PP-OCR 검출기는 둥근·흰 알약을 통째로 박스 쳤다(약 40~50%). | Florence-2 를 fine-tune 없이 채택. 어두운 알약의 G·H 도 글자에 딱 맞게 잡아 약 85%. | 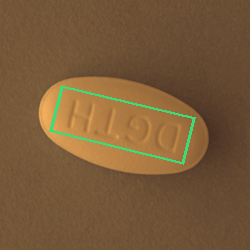 | 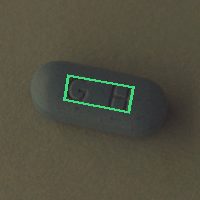 |
| 3 | 흰 알약의 얕은 양각 S 는 Florence-2 도 찾지 못했다. | 검출이 비면 CLAHE 와 unsharp 로 대비를 키워 다시 찾는 단계를 넣었다. | 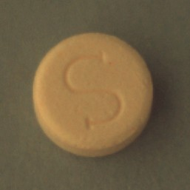 | 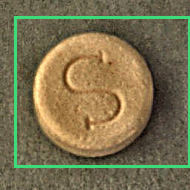 |
| 4 | 검출 박스가 기울어 있어 그대로 자르면 글자가 잘리거나 기운 채 들어갔다. | 최소 외접 사각형으로 박스를 수평으로 펴서 잘랐다. | 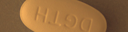 | 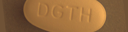 |
| 5 | 수평은 맞췄지만 180° 뒤집힌 각인이 절반 가까이 남았다. 왼쪽에서 오른쪽으로 읽는 인식기는 뒤집힌 글자를 못 읽는다. | 방향 분류기로 0°/180° 를 판정해 바로 세우고, 학습 crop 을 다시 만들었다. | 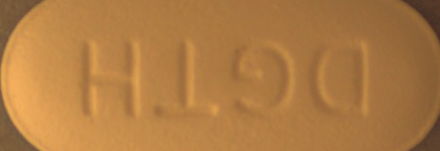 | 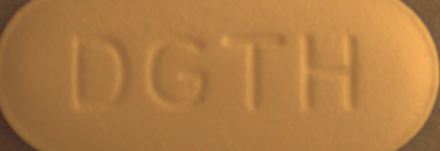 |
| 6 | 검증 정확도 45% 에서 멈췄다. 실패 이미지를 보니 양면 약의 앞·뒷면 정답이 서로 바뀌어 있었다(37%). 이미지는 3 인데 정답은 JH 였다. | 데이터 품질 문제로 분류하고 교정하지 않기로 했다. 데이터를 5.4배 늘려도 최고치가 같아, 양보다 품질이 천장이라는 걸 확인했다. | 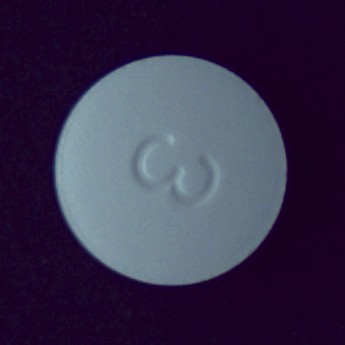 | 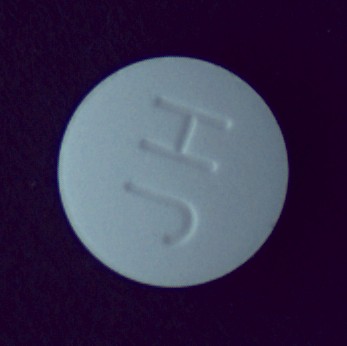 |
| 7 | 각인이 두 영역(PST / 150)이면 한쪽만 잘려 PST150 을 PSPST 로 읽었다. 실패 18장 중 7장이 이 경우였다. | 읽은 결과가 정답의 일부분이면 학습에서 빼는 필터를 넣고 재학습해 57.0%. | — | — |
| 8 | 진짜 관문은 휴대폰 실사진이다. 작은 흰 알약 R3 는 잘라 보면 글자가 거의 남지 않아 3 으로 읽혔다. Apple Vision 도 이 사진은 틀렸다. | 실사진 14장을 고정 벤치마크로 두고, 여기서 기준선을 이기기 전에는 앱 모델로 올리지 않는 게이트를 유지했다. | 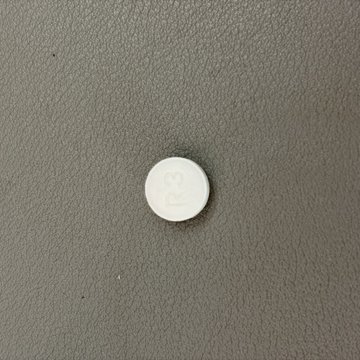 | 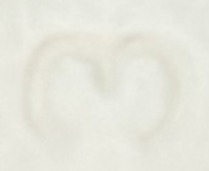 |
틀린 진단을 정정한 기록
이 프로젝트에서 남길 만한 건 최종 수치보다 진단을 여러 번 뒤집은 과정이다. 처음 떠오른 원인이 맞았던 건 한 번뿐이었다.
| 증상 | 처음 진단 | 실제 원인 |
|---|---|---|
| 학습 정확도 0 | 학습률이 너무 높다 | 맞았다. 학습률을 1/5 로 낮추고 warmup 을 넣어 빈칸만 출력하는 붕괴를 피했다. 소규모 시험 덕에 7일짜리 학습을 낭비하기 전에 1.5시간 만에 잡았다. |
| 뒷면 데이터 절반이 버려짐 | 데이터 문제 | 코드 한 글자. 라벨은 "뒷면" 인데 코드는 "뒤" 를 찾았다. 고치자 쓸 수 있는 데이터가 41% 늘었다. |
| 파일럿 과적합 | 데이터가 부족하다 | 검증셋 분리 문제. 임의 해시로 나누자 같은 품목이 양쪽에 들어갔다. AI Hub 원본의 품목 단위 분할을 쓰자 학습·검증 곡선이 같이 움직였다. |
| 검증 30% 정체 | 인식기의 한계 | 입력 문제. 정사각 알약을 32×128 로 눌러 넣어 글자가 뭉개졌다. 각인만 검출해 넣자 45 → 50 → 57%. |
| 데이터 5.4배 증량 | 많이 넣으면 오른다 | 최고치 45.23% 로 같았다. 실패 18장은 라벨 뒤바뀜 8, 부분 crop 7, 나쁜 crop 3 이었다. |
| Apple Vision 먼저, 실패만 PARSeq | 둘을 이으면 낫다 | "글자가 4자 이상이면 확신" 이라는 게이트가 오독(TRAMOL → RAMOI)을 확신으로 처리해 PARSeq 를 건너뛰었다. 게이트를 각인 사전 확증으로 바꾸고, 결국 PARSeq 하나로 되돌렸다. |
실험하며 겪은 일 — 앱에 넣었다가 뺀 일주일
7월 26일 연구 결과를 약국통 앱에 붙였다. 각인 영역 검출 모델과 PARSeq 모델을 앱 번들에 넣고, 촬영·양면 검토 화면과 후보 랭킹까지 연결했다. 추론 로직은 테스트할 수 있는 순수 함수(core)와 기기에서 모델을 부르는 부분(native)으로 나눴다.
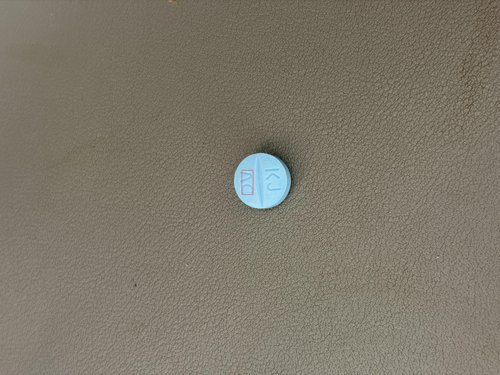
7월 27일 앱에서 새 문제가 나왔다. 분할선 양쪽에 KJ 와 AC 가 새겨진 알약은 검출기가 박스를 하나만 잡았고, Apple Vision 은 KJ 만 읽었다. Apple Vision 을 먼저 쓰고 실패한 것만 PARSeq 로 넘기는 연결을 실험했다가, 위 표의 게이트 문제로 순수 PARSeq 로 되돌렸다.
7월 28일 출시 버전에서 알약 검색을 통째로 뺐다. 화면·추론 코드·모델 파일을 모두 걷어냈다. 실사진 벤치마크에서 기준선을 이긴다는 검증이 끝나지 않아, 7월 21일에 정한 승격 게이트를 통과하지 못했기 때문이다. core 와 native 를 나눠 둔 덕에 화면 진입점과 모델 파일만 끊으면 됐다. 약국통 1.0 은 바코드·낱알 세기·뉴스로 범위를 고정해 8월 15일 iOS 심사를 통과했다.
돌아보며
출시에서 뺀 건 실패라기보다 게이트가 작동한 결과다. 기준을 먼저 정해 두지 않았다면, 검증셋 57% 라는 숫자를 들고 앱에 그대로 넣었을 것이다.
남은 것도 분명하다. 배포 관문인 실사진 벤치마크에서 Apple Vision 대비 개선은 아직 측정하지 않았다. 양면 라벨 37% 는 교정하지 않았고, 교정하면 63.4% 까지 오를 수 있다는 참고값만 있다. 인식 문자는 영문·숫자만 다뤄서 한글 각인은 범위 밖이다. 가장 오래 남는 교훈은 실패한 이미지를 직접 들여다본 순간마다 진단이 바뀌었다는 것이다.
출처
- 포트폴리오 저장소
~/Workspace/portfolio/cases/09-pill-ocr.qmd와data/metrics.yml의 DATA-SIDE-PILL-* 지표, 단계별 이미지 ~/Playground/pill-ocrREADME, OCR 벤치마크 JSON, 학습 실행 계획과 18개 버전 리포트- 약국통 커밋(7/26 앱 통합, 7/28 출시에서 분리)
- 참조한 오픈소스(GitHub): PARSeq · PaddleOCR · EasyOCR · PyTorch · OpenCV · ONNX Runtime. Florence-2 는 GitHub 저장소 없이 Hugging Face 로만 공개돼 뺐다.
- 이미지는 AI Hub 경구약제 공개 데이터와 직접 찍은 사진만 쓴다. 학습 장비의 접속 정보, 실사진 원본, 학습 체크포인트는 싣지 않는다.